こんにちは。AlgomaticでソフトウェアエンジニアをしているGo(@53able)です。
AIに大きなCSVや長いログを読ませようとして、送信量の上限や費用に困ることがあります。質問に関係のない行まで送れば入力は増えます。一方、先頭から一定量だけを送ると、判断に必要な行を落としかねません。
そこで、LLM(大規模言語モデル。ChatGPTなどの文章生成AIの中核)へ丸ごと送る前に、手元のPCやLLMの外で動くスクリプトでデータを整理します。LLMへ渡すのは、件数、代表例、元データの位置、必要な原文を追加取得する方法です。
| 困りごと | この方法で改善を狙えるか |
|---|---|
| 送るデータ量や入力トークンが多い | 改善を狙える。ただし回答品質との比較が必要 |
| 短時間に送るリクエスト回数が多い | 直接は解決しない |
この方法は、情報を減らしても回答品質を守れた場合だけ節約策として採用します。本稿で参照する研究は、短い指示、履歴の整理、コード検索などを個別に評価しています。本稿で提案する組み合わせ全体を直接評価した研究はなく、統合した仕組みの効果もまだ測っていません。
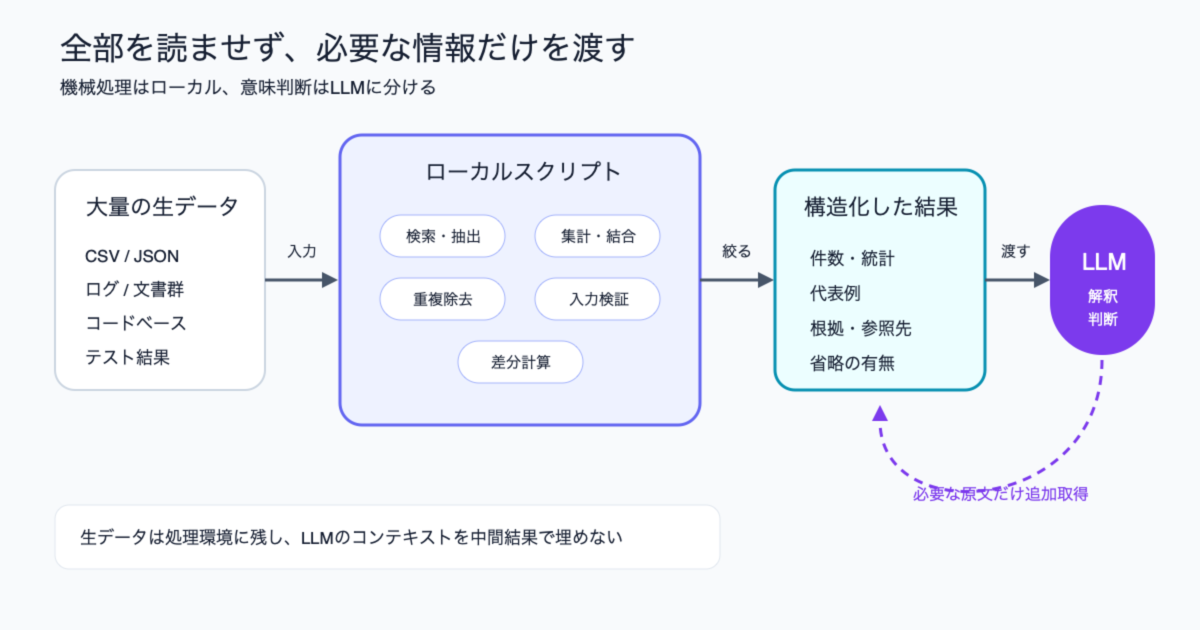
生データは処理環境に残し、LLMには整理した結果だけを渡します。LLMが追加の根拠を必要とした場合に限り、元データの該当範囲を取得します。
- 6行のCIログなら、何を渡すか
- 丸ごと送る前に、機械で整理する
- 常に読む指示と、必要なときだけ読む資料を分ける
- 手順が決まっている部分はスクリプトに固定する
- 古い出力は消さず、必要時に戻れるようにする
- 大量の中間データはLLMの外で絞る
- 概要には、件数・代表例・位置・追加取得先を入れる
- 実装したい人向け:6行のCIログを集約する
- 手元で処理するだけでは、情報流出を防げない
- 品質を先に測り、守れた場合だけ費用を見る
- まとめ:品質を守れた場合だけ節約策として採用する
- エンジニアを募集しています!
- 参考文献
6行のCIログなら、何を渡すか
まずはコードを使わず、6行だけのCIログで考えます。CIログとは、ビルドやテストを自動実行した記録です。
| 行 | 記録 |
|---|---|
| 1 | ビルド開始 |
| 2 | 再試行1回目の警告 |
| 3 | 再試行2回目の警告 |
| 4 | 5432番ポートへの接続拒否エラー |
| 5 | 5432番ポートへの接続拒否エラー(同じエラーの繰り返し) |
| 6 | ビルド失敗 |
6行すべてを渡す代わりに、まず次の概要をLLMへ渡します。
- 全6行のうち、警告とエラーは4行
- 同種の警告が2件、同種の接続拒否エラーが2件
- エラーの代表例は「connection refused port 5432」
- 元の位置は4〜5行目
- 詳しく読むなら、同じログの2〜6行目を追加取得できる
LLMが原因を判断するのに4〜5行目だけでは足りなければ、前後を追加で読みます。最初から原文を捨てるのではなく、概要から元の位置へ戻れるようにするのが要点です。この6行例では、同じ警告が繰り返される大きなログをどう整理するか、最小の形で確認します。
ここでいうコンテキストとは、LLMが一度の処理で参照する指示、会話履歴、データのまとまりです。コンテキストを減らす目的は、短く見せることではありません。必要な証拠を残したまま、質問に関係のない入力を減らすことです。
丸ごと送る前に、機械で整理する
LLMが読まなくても答えが決まる処理は、通常のプログラムに任せます。
- CSVや、項目名と値の組でデータを表すJSONの絞り込み、グループ化、結合、集計
- ログの頻度集計、エラー抽出、重複除去
- 文書の見出しや作成日などの付随情報の抽出、全文検索
- テスト結果や差分の整理
- すでに送ったデータと同じかどうかの判定
- コードの構造、名前、つながりの抽出
コードを調べるときには、次の用語が出てきます。
- AST(抽象構文木):ソースコードを、関数や条件分岐などの構造として表したもの
- シンボル:関数名、クラス名、変数名など、コード中で名前を付けた要素
- 依存関係:あるファイルや関数が、別のファイルや関数を呼び出したり利用したりする関係
たとえば「どこでsendMailを呼んでいるか」を調べるなら、全ファイルをLLMへ送る前に、名前の一致箇所と呼び出し関係を検索できます。LLMには候補のファイル名、行番号、一致した理由を渡し、必要な範囲だけ追加で読ませます。
同じ入力に対して同じ結果を返す処理なら、入力、スクリプト、利用ライブラリ、実行環境を記録しておくと再現しやすくなります。ただし、スクリプトを使えば自動的に品質が保たれるわけではありません。
評価前に、正しい判断に必要なレコード、ログ行、コード範囲を「必須証拠項目」として決めます。そして、必要な証拠を拾えた割合(recall、再現率)と最終タスクの成功率を、全文を渡す方式と比べます。必要な根拠を落としたなら、トークンが減っても失敗です。
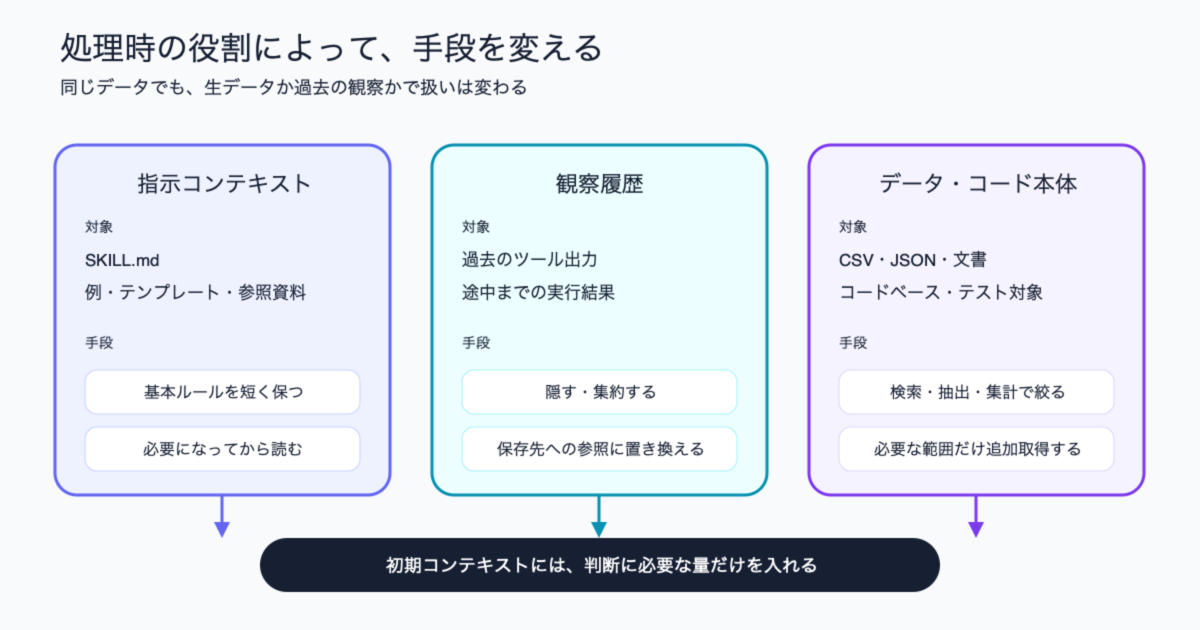
指示は短く保ち、古い履歴は再取得できる参照へ置き換え、生データは検索・集計してから渡します。減らす対象によって手段を変えます。
ここからは、この設計を考えるために参照した研究と、その適用範囲です。まず試す手順を知りたい場合は、目次から「品質を先に測り、守れた場合だけ費用を見る」へ進んでください。
常に読む指示と、必要なときだけ読む資料を分ける
エージェントスキルは、AIに仕事の手順や利用できる道具を教える一式です。その中心となるSKILL.mdには、利用条件、最小限の手順、スクリプトの入口だけを置きます。例、テンプレート、背景説明、詳しい資料は、必要になってから読みます。
SkillReducerも、常に読み込む短い基本ルールと、必要時に読む補足資料の二層に分けています。同研究は600件のスキル本文を平均39%圧縮しましたが、圧縮後の評価点の上昇は小さく、評価方法も圧縮時のフィードバックと完全には独立していません。
同論文のSkillsBench評価では、元のスキルと圧縮条件はともに87/87タスクで用意された自動テスト(pytest verifier)に合格し、スキルなしでも86/87タスクが合格しました。この評価では差がほとんど見えません。したがって本稿が採用するのは「短くすれば性能が上がる」という結論ではなく、常時読む内容と必要時に読む内容を分ける設計だけです。
手順が決まっている部分はスクリプトに固定する
入力の形式確認、集計、分岐条件など、規則で答えが決まる処理はスクリプトへ固定します。LLMには、曖昧な依頼の解釈やエラーログの意味判断など、文章の前後関係を読まないと決められない仕事を残します。
- 既知の手順はスクリプトに固定する
- 機械的に判定できる条件分岐や検証はLLMへ任せない
- LLMへ渡す仕事と出力形式を狭く定義する
- 同じ計算を毎回自然言語で考え直させない
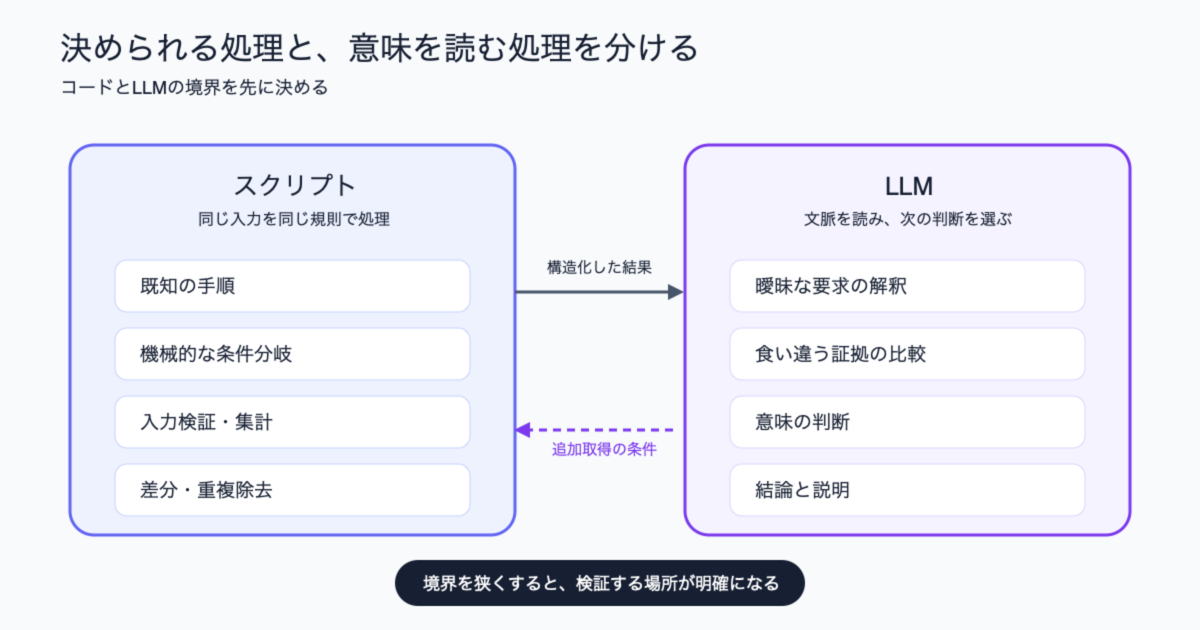
同じ入力を同じ規則で処理する仕事はスクリプトへ固定し、食い違う証拠の比較や意味判断をLLMへ残します。
この役割分担に近い設計例が、Blueprint First, Model Secondです。提案手法のSCA(Source Code Agent)は、手順、分岐、制約をソースコードへ定義し、範囲を限定した複雑な処理でLLMを呼びます。
TravelPlannerの1,000件のテストタスクでは、同じClaude Sonnet 4を使った比較で、最終合格率がATLASの18.00%に対してSCAは35.56%でした。ただし、明示されたユーザー要件の違反数はSCAの方が多く、すべての制約が改善したわけではありません。この研究だけで「手順をコードへ移せば必ず良くなる」とは言えないため、本稿では事前に手順を決められる作業に限って試します。
古い出力は消さず、必要時に戻れるようにする
AIがツールを何度も使うと、過去の検索結果やコマンド出力が会話にたまります。Observation Maskingは、古い出力をLLMから見えない状態にする方法です。要約用の別のLLM呼び出しで履歴を短くまとめ、元の出力と置き換える方法もあります。
The Complexity Trap: Simple Observation Masking Is as Efficient as LLM Summarization for Agent Context Managementは、実在するソフトウェア修正課題を集めたSWE-bench Verifiedで両者を比較しました。5つのモデル設定では、費用と解決率のどちらでも、LLM要約がMaskingを一貫して上回りませんでした。
最大57.1%のコスト削減を記録したMasking条件では、解決率が40.4%から36.4%へ下がっています。組み合わせ方式も設定によって改善と悪化の両方がありました。費用が下がっても、答えの質を守れるとは限りません。
本稿では、古い出力をただ隠すのではなく、元データへ戻るための情報を残します。これは同研究が直接評価した方式ではなく、未評価の設計案です。
- 成功したコマンドは終了コードと件数を返し、詳しいログの保存先を示す
- 同じ警告は、出現回数、代表例、元の行番号にまとめる
- 変更のないレコードは最初の出力から除き、必要時に取得できるようにする
- 上限を超えた結果は分割する
- 一度読んだ結果は、保存先の識別子と、内容が変わっていないか確かめるハッシュ値で参照する
大量の中間データはLLMの外で絞る
MCP(Model Context Protocol)は、AIから外部のツールやデータを共通の方法で利用するための仕組みです。AnthropicのCode execution with MCPは、本稿の構想に近い実装例を紹介しています。これは学術論文ではなく、ベンダーの技術記事です。
一般的なMCPクライアントは、利用可能なツールの説明を最初にコンテキストへ読み込みます。中間結果もコンテキストへ入り、同じデータを次のツールへ渡すと、モデルがもう一度出力する場合があります。
コード実行方式では、必要なAPIだけを読み、LLMの外にある実行環境で絞り込み、結合、集計を済ませます。この実行環境は手元のPCとは限りません。LLMへ返すのは処理後の結果だけです。
Anthropicの記事は、ツール定義による使用量を150,000トークンから2,000トークンへ減らせると説明していますが、測定条件は記事にありません。スプレッドシートの例では、10,000行を実行環境で絞り込み、件数と先頭5行だけを返しています。
コードベースでも原則は同じです。RepoScopeは関数などの呼び出し関係と内容の似ている度合いから候補を選び、cASTはASTの境界を優先してコードを分け、LongCodeZipはトークン予算を超えたコードを圧縮します。「選ぶ、構造を保って分ける、それでも多い場合だけ縮める」という順序は、三研究が一体として評価した方式ではありません。本稿で組み合わせた設計案として、導入時に比較します。
概要には、件数・代表例・位置・追加取得先を入れる
検索で10ファイルが見つかっても、10ファイルの本文を自動でLLMへ渡す必要はありません。候補のファイル名、行番号、一致理由を返し、LLMが選んだ範囲だけ追加取得します。
CodeGrepのSWE-bench Verified評価では、単語の一致度から順位を付けるBM25の上位2件について、候補ファイルのパス一覧をissue descriptionへ追加すると、解決率は25.8%から25.2%へ0.6ポイント下がりました。ファイル本文を追加した実験ではありません。この一条件だけで、候補提示が常に悪いとは判断できません。また、本稿のように候補一覧から必要箇所を追加取得する方式は、CodeGrepで直接評価されていません。
最小構成は、短い指示、機械処理を行うスクリプト、出力形式の説明です。
my-data-skill/
├── SKILL.md
├── scripts/
│   ├── inspect.py
│   ├── filter.py
│   ├── aggregate.py
│   └── verify.py
└── references/
    └── output-schema.md
SKILL.mdには利用条件、入力形式、スクリプトの入口、失敗時の手順、トークン上限を書きます。入力確認、絞り込み、集計、結合、重複除去、差分計算、元の位置の付与はスクリプトへ移します。LLMに残すのは、曖昧な依頼の解釈、証拠の比較、次に読むデータの選択、結論の作成です。
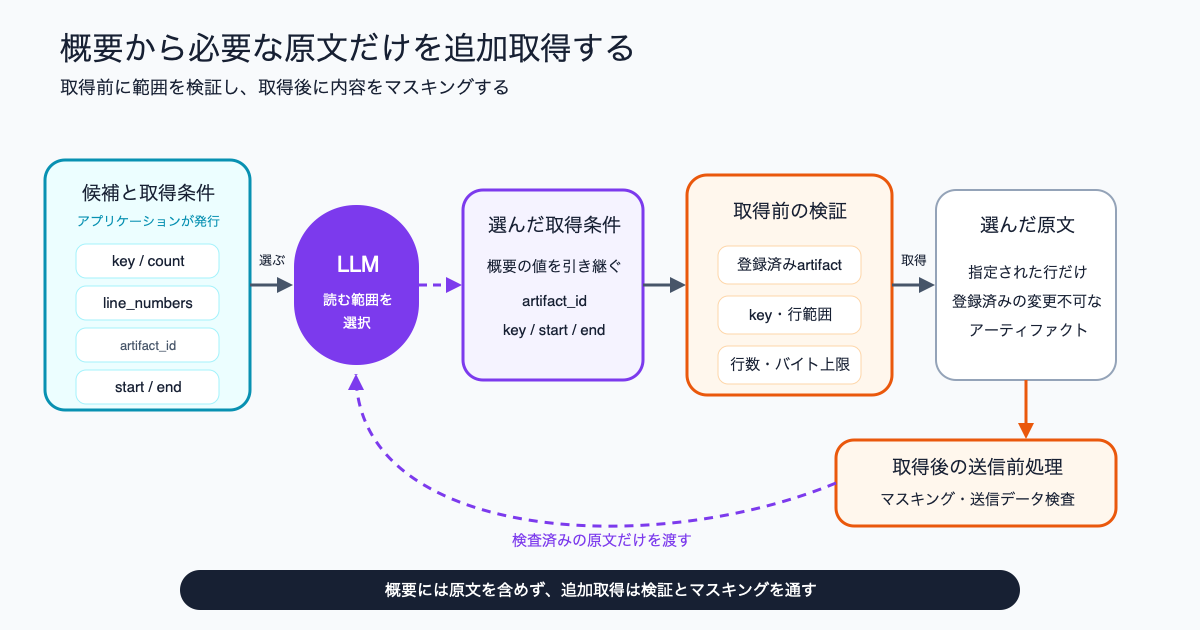
候補にはartifact_idと行範囲を含めます。アプリケーションは登録済みの変更不可な保存物と照合し、許可した範囲だけを取り出して送信前検査へ渡します。
実装したい人向け:6行のCIログを集約する
ここからのPython、bash、JSONは、ログを集約して候補を作る部分だけの実装例です。artifact_idは保存物を指す識別子、keyは候補グループの名前です。artifactの認可と取得、隔離実行、モデル出力形式の検査、送信前検査は実装していません。このコードだけを、外部LLMへ安全に接続できる最小実装として使わないでください。
実装しない場合は「手元で処理するだけでは、情報流出を防げない」へ進んでください。
冒頭の6行を、今度はci.logとして保存します。
2026-08-29T10:00:00Z INFO build started
2026-08-29T10:00:01Z WARN retry 1
2026-08-29T10:00:02Z WARN retry 2
2026-08-29T10:00:03Z ERROR connection refused port 5432
2026-08-29T10:00:04Z ERROR connection refused port 5432
2026-08-29T10:00:05Z INFO build failed
Pythonは汎用プログラミング言語です。次のscripts/inspect.pyは、WARNとERRORを抽出します。時刻を除き、retryの直後にある再試行番号だけを<n>へ置き換えて、同じ警告をまとめます。ポート番号やエラーコードは原因判断に必要な可能性があるため、そのまま残します。
#!/usr/bin/env python3
import argparse, hashlib, json, re
from collections import defaultdict
from pathlib import Path

LEVEL = re.compile(r"\b(?:ERROR|WARN)\b")
TIMESTAMP = re.compile(r"^\d{4}-\d{2}-\d{2}T\S+\s+")
RETRY_NUMBER = re.compile(r"(?<=retry )\d+\b")

parser = argparse.ArgumentParser()
parser.add_argument("log", type=Path)
parser.add_argument("--limit", type=int, default=5)
args = parser.parse_args()

raw = args.log.read_bytes()
sha256 = hashlib.sha256(raw).hexdigest()
artifact_id = f"sha256:{sha256}"
lines = raw.decode("utf-8", errors="replace").splitlines()
groups = defaultdict(list)
for number, line in enumerate(lines, 1):
    if LEVEL.search(line):
        without_time = TIMESTAMP.sub("", line.strip())
        key = RETRY_NUMBER.sub("<n>", without_time)
        groups[key].append((number, line.strip()))

findings = []
for key, hits in sorted(groups.items(), key=lambda item: (-len(item[1]), item[0])):
    first = hits[0][0]
    findings.append({
        "key": key,
        "count": len(hits),
        "line_numbers": [number for number, _ in hits[:5]],
        "next": {
            "artifact_id": artifact_id,
            "start": max(1, first - 2),
            "end": min(len(lines), first + 2),
        },
    })

print(json.dumps({
    "artifact_id": artifact_id,
    "total_lines": len(lines),
    "matched_lines": sum(len(hits) for hits in groups.values()),
    "groups": findings[:max(0, args.limit)],
    "truncated": len(findings) > max(0, args.limit),
}, ensure_ascii=False, indent=2))
bashは、ターミナルでコマンドを実行するための仕組みです。次のコマンドは上位1グループだけを取得し、結果をsummary.jsonへ保存します。
python3 scripts/inspect.py ci.log --limit 1 > summary.json
JSONは、項目名と値の組でデータを表すテキスト形式です。この入力では6行のうち4行が対象になり、2グループへまとまります。--limit 1を指定した出力は次のとおりです。
{
  "artifact_id": "sha256:4359e44603e37937c6165642b8410ea08b51cd85af6ca605052428b201d37555",
  "total_lines": 6,
  "matched_lines": 4,
  "groups": [
    {
      "key": "ERROR connection refused port 5432",
      "count": 2,
      "line_numbers": [
        4,
        5
      ],
      "next": {
        "artifact_id": "sha256:4359e44603e37937c6165642b8410ea08b51cd85af6ca605052428b201d37555",
        "start": 2,
        "end": 6
      }
    }
  ],
  "truncated": true
}
LLMはこの概要を見て、詳しく読むグループのkeyを選びます。アプリケーションはartifact_idを、事前に登録した変更不可の保存物と照合し、next.startからnext.endまでだけを取得します。LLMが返した値はそのまま信用せず、key、行範囲、データ量が許可範囲内かをアプリケーション側で確認します。ログ本文はAIへの命令ではなく、分析対象のデータとして扱います。
手元で処理するだけでは、情報流出を防げない
スクリプトを手元のPCで動かしても、AIが生ファイルやターミナルを自由に使えるなら、データを外部へ送れてしまいます。
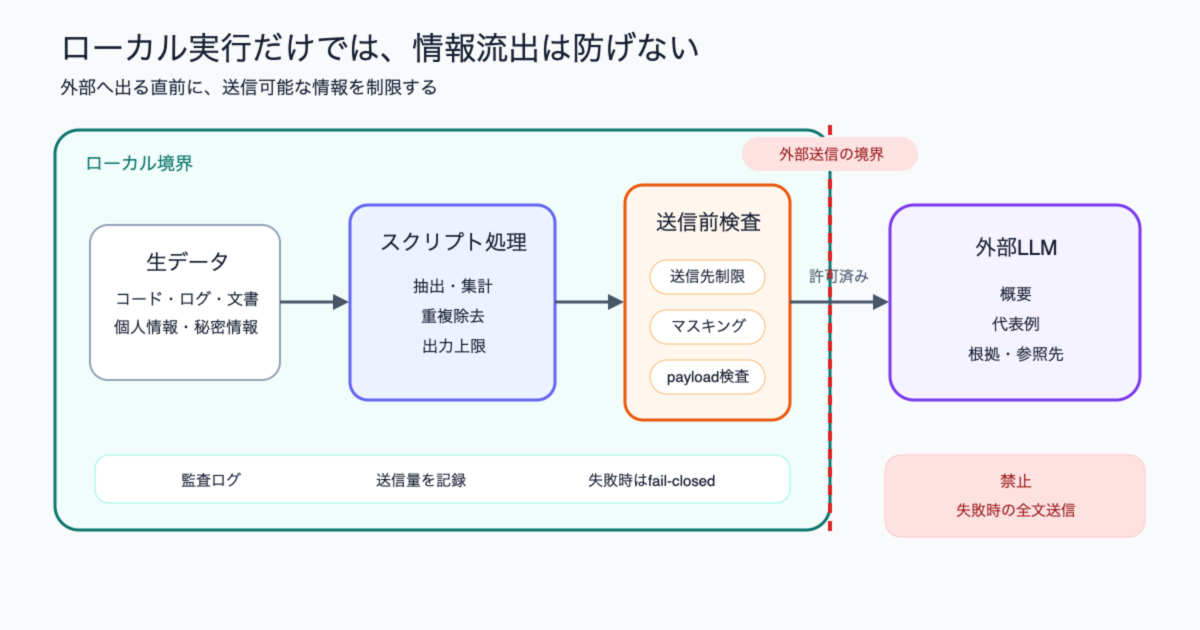
ローカル実行だけでは送信を制限できません。実行権限と送信先を絞り、外部へ出る直前に内容を検査し、失敗時には送信を止めます。
実行する場所は、ほかのファイルやネットワークへ自由に触れない隔離環境(sandbox、サンドボックス)にします。CPU、メモリ、実行時間、読めるファイル、子プロセス、ネットワークに上限を設けます。生データを返す道具は最初から許可せず、出力先は許可した項目の一覧(allowlist、許可リスト)に限定します。
外部LLMへ送るデータは事前に検査し、APIキー、個人情報、秘密情報を伏せます。記録には、入力内容を識別するハッシュ値、実行コマンド、出力のハッシュ値、送信量を残します。処理に失敗した場合も、自動で全文送信へ切り替えません。採用前に、伏せ字の漏れ、参照先のアクセス権、失敗時に送信が止まることをテストします。
品質を先に測り、守れた場合だけ費用を見る
ここまでの構成は、統合システムとしてまだ評価していません。ContextBenchは、最終タスクの成功率に加えて、検索結果のうち正解の文脈が占める割合であるprecision(適合率)、必要な証拠を拾えた割合(recall、再現率)、両者を一つにまとめたF1を測ります。F1は、どちらか一方が低ければ低くなる指標です。
ContextBenchは、探索中に見つけた正解文脈が最終コンテキストへ残ったかも調べます。ただし、残った正解文脈が最終回答に使われたとは限りません。また、これらの指標だけでは費用と所要時間は分かりません。
本稿では、まず最終タスクの成功率と必要な証拠を拾えた割合(recall、再現率)を確認し、両方が基準を満たした場合だけ、費用と所要時間を判定します。
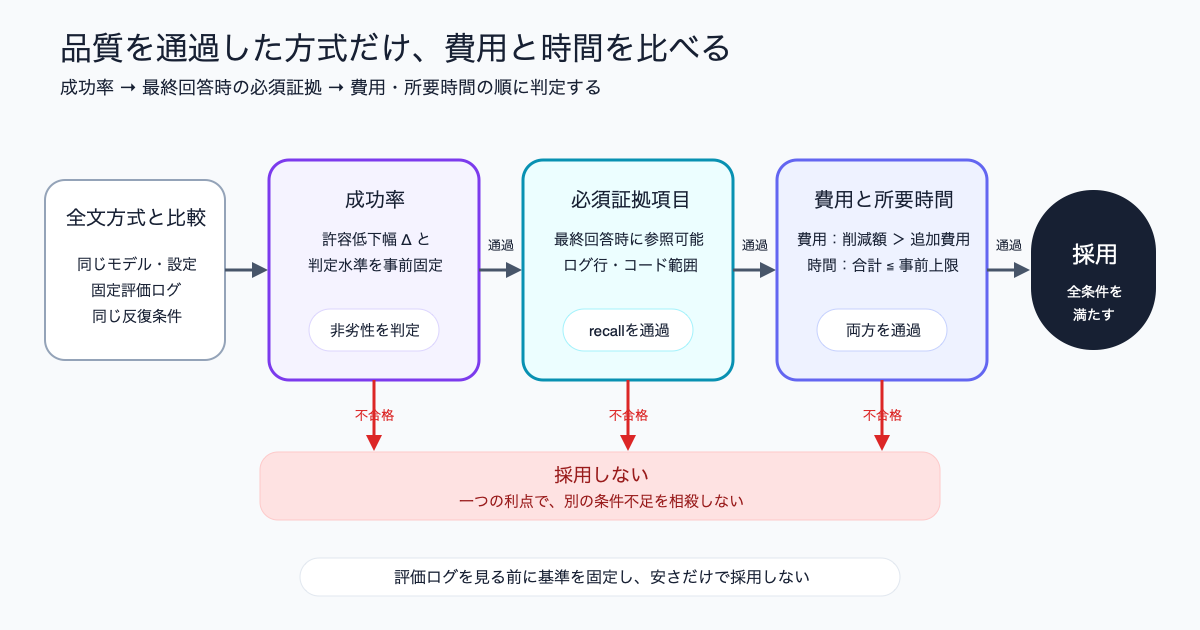
成功率と最終回答時の必須証拠を先に確認します。どちらも基準を満たした方式だけ、費用と所要時間の比較へ進めます。
最初は、冒頭のように同じ接続拒否エラーと再試行の警告が繰り返されるCIログを一つ使います。全文方式と、重複をまとめて件数、代表例、行番号を返す方式に、同じ失敗原因と修正候補を答えさせます。1件目では、概要から必要なログ行を追加取得できるところまで確認し、採用判断はしません。
本採用の前には、原因や形式が異なるログを複数用意します。各ログについて、判断に必要な行、期待する失敗原因、許容できる修正候補を先に記録します。全文方式とスクリプト方式は、同じモデルと設定で比べます。
抽出規則を調整する開発用ログと、採用判断に使う固定評価ログは分けます。必須証拠、同じ意味とみなす証拠、判定基準は、固定評価ログを見る前に決めます。対象ログの抽出方法、最低ユニークログ数、反復回数、実行順、タイムアウトと失敗の扱いも事前に記録し、同じログの反復を独立したログとして数えません。
確認する順番は次のとおりです。
- 答えの質を守れたか:原因判断や修正候補の成功率が、全文方式より悪化していないか
- 必要な証拠を最後まで残せたか:一度見つけただけでなく、最終回答を作る時点でも必須のログ行を参照できるか
- 本当に節約できたか:最初の二つを満たした場合だけ、トークン費用、計算費用、実装・保守・再検証の時間を比べる
ここからは、継続導入を厳密に判定する場合の発展的な内容です。最初の試行では読み飛ばせます。
継続導入を統計的に判断するなら、許容できる品質低下幅Δと判定水準を実験前に決めます。スクリプト方式と全文方式の成功率差をd、その片側信頼下限をLとすると、Lが−Δを上回る場合に非劣性と判定します。Δ=0でL>0を求めるなら、「悪化していない」ではなく「全文方式より優れている」ことを求める、より厳しい判定です。
トークン削減で、成功率や必須証拠項目の不足を埋め合わせることはしません。
処理手段は一度に増やしません。まず規則をスクリプトへ固定します。表記の違いを単純な規則で扱えない場合に、文章やコードの意味の近さを数値で比べるローカル埋め込みを加えます。それでも候補が多すぎる場合だけ、小型のローカルモデルによる圧縮を試します。「選ぶ、分ける、縮める」の順に一段ずつ比較すれば、どの変更が結果へ影響したかを追いやすくなります。
まとめ:品質を守れた場合だけ節約策として採用する
LLMへ大量データを丸ごと送る前に、手元またはLLMの外で動くスクリプトで整理します。LLMへ渡すのは、件数、代表例、元の位置、原文の追加取得先です。必要なら元データへ戻れるようにし、最初から捨て切りません。
関連研究は、スキルの段階的な読み込み、決められた処理のコード化、古いツール出力の非表示、実行環境での絞り込みを個別に扱っています。しかし、研究ごとに対象と指標が異なります。本稿の統合方式を直接評価した結果はなく、この構成によるトークン削減とタスク性能も未測定です。
入力トークン量を減らせれば、その量に応じた制限や費用には効く可能性があります。一方、リクエスト回数そのものに基づく制限は直接解決しません。全文方式と同じ条件で比べ、最終タスクの成功率と必要な証拠を拾えた割合(recall、再現率)を守れた場合に限って、費用と所要時間を見ます。
最初から大規模な検索基盤を作る必要はありません。次の3手順から始めます。
- 全文をLLMへ送っているログ処理を一つ選ぶ
- 重複をまとめ、件数、代表例、元の行番号を返す
- 同じ質問を全文方式とスクリプト方式へ渡し、答えと証拠の見落としを比べる
答えの質と必要な証拠を守れた場合だけ、送信トークン、費用、所要時間の比較へ進みます。
エンジニアを募集しています!
ここまで読んでいただきありがとうございました!
Algomatic では、「AI革命で人々を幸せにする」をミッションに、変化の速い領域でも 学びや試行錯誤を続けられる エンジニアを募集しています。
もし少しでもご興味をお持ちいただけましたら、カジュアル面談に足を運んでいただけるとうれしいです!
参考文献
- SkillReducer: Optimizing LLM Agent Skills for Token Efficiency
- Blueprint First, Model Second: A Framework for Deterministic LLM Workflow
- The Complexity Trap: Simple Observation Masking Is as Efficient as LLM Summarization for Agent Context Management
- Code execution with MCP: building more efficient AI agents
- RepoScope: Leveraging Call Chain-Aware Multi-View Context for Repository-Level Code Generation
- cAST: Enhancing Code Retrieval-Augmented Generation with Structural Chunking via Abstract Syntax Tree
- LongCodeZip: Compress Long Context for Code Language Models
- ContextBench: A Benchmark for Context Retrieval in Coding Agents
- CodeGrep: An RL-Trained Retrieval Agent for LLM Coding Agents
